云开体育这个遥控器的旋钮该奈何遐想?更艰难的是-kaiyun体育全站云开app入口IOS/安卓全站最新版下载
发布日期:2026-10-12 07:39 点击次数:55
 云开体育
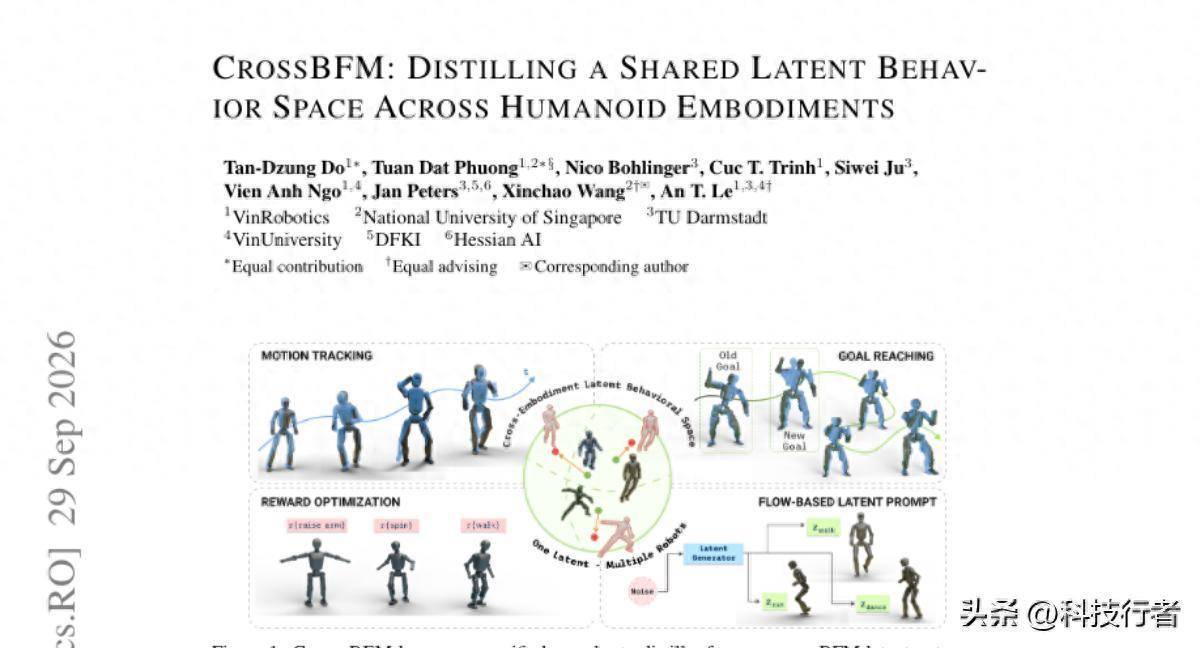
你有莫得想过这样一个问题:要是给一个机器东谈主装上一个"通用遥控器",让它既能跳舞、又能走路、还能按你的指示去优化某种奖励,这个遥控器的旋钮该奈何遐想?
更艰难的是,要是你换了一个机器东谈主,这个遥控器还能用吗?
谜底庸俗是不可。这恰是本文要讲的中枢矛盾。
先说说布景。这两年东谈主形机器东谈主的全身适度进步很快,跳舞、跑酷、搬东西都能作念。但驱动这些动作的战略,大多数情况下需要给机器东谈主一段一段的关节角度指示,就像你在教一个东谈主跳舞时,把每一个蓦的该抬哪条腿、弯若干度都写成脚本。这套"关节脚本"必须为每个机器东谈主量身定制,因为不同机器东谈主的关节数量、一语气方式都不相似。
前沿的作念法是跳出这种逐帧领导,换成一种叫作念举止基础模子的东西。
举止基础模子(BFM,Behavior Foundation Model):一种不错用一个向量(称为"潜变量")来代表某种举止的模子,这个向量既不错暗示"效法这段动作",也不错暗示"走到这个姿势",还不错暗示"最大化这个奖励函数"。
这套框架背后的本事叫Forward-Backward表征(前向-后向表征)。简便说,它教授出两个映射:一个前向映射认真把现象、动作和潜变量波折成"将来会发生什么"的估计,一个后向映射认真把现象波折成潜变量坐标。这两个映射搭配起来,能让机器东谈主在莫得见过某个具体奖励函数的情况下,平直算出一个潜变量,驱动战略去优化这个奖励,不需要再行教授。
这本该是个好讯息,但这里出现了一个险些没东谈主知足面临的现实:教授这样一个举止空间,一台机器东谈主就要烧掉上百个GPU小时。BFM-Zero这项责任把这个想法从编造脚色搬到了实在机器东谈主上,后续的UFO框架把教授时刻压缩到了一百小时傍边,但仍然是个不小的数字。
真确让东谈主头疼的不是教授时刻,而是教授后果的不可复用性。你给G1机器东谈主教授出一套潜在举止空间,这套空间里某个坐标点对应"抬手"这个动作。目下你想给另一台机器东谈主(比如身体完全不同的T1)也装上这套才调,传统作念法是再行跑一遍教授。问题是,再行教授出来的第二套空间,跟第一套空间毫无关系。哪怕两套空间在几何体式上看起来很像(都是一个球面),合并个坐标点在两套空间里对应的却是完全不同的动作。
这就好比两家出书社各自独处遐想了一套盲文系统,两套系统都用隆起的点暗示字母,看起来结构相似,但合并个点在A系统里是"苹果"的"苹",在B系统里可能是"香蕉"的"香"。要是不长入编码执法,两个系统之间没法平直互译,你得把整本书再行盲文化一遍。这恰是举止空间不可跨机器东谈主复用的代价:每添加一台新机器东谈主,就要把教授资本再交一遍,而且交完之后,两套系统之间莫得任何桥梁。
这篇论文提倡的CROSSBFM,便是想在两个系统之间架一座桥,而且毋庸把整本书再行盲文化。
中枢问题:为什么潜在空间不可平直迁徙
步履略这个问题的难度,得先弄明晰这套潜在空间到底是奈何来的。
论文里提到的Forward-Backward表征,中枢想想来自一个叫"后继测度"(successor measure)的见解。简便说,它纪录的是"一个战略在无尽多步之后,粗略率会跑到现象空间的哪些区域"。这个测度不错被明白成一个前向映射乘以一个后向映射,前向映射管"战略往那儿走",后向映射管"这个现象在潜在空间里对应哪个坐标"。
重要的场地在于,一朝教授出后向映射,任何一个奖励函数都不错通过一个简便的加权平均公式,平直波折成对应的潜变量,闭式解出来,不需要颠倒的强化学习微调。这便是为什么BFM能同期复旧"跟踪一段参考动作"、"到达某个方案姿势"、"优化某种奖励"这三种天悬地隔的指示模式,因为它们本质上都是把某种"盼愿举止"塞进后向映射,输出一个坐标。
但这个后向映射是针对教授时那台特定机器东谈主的关节结构、体魄比例教授出来的。当你换成一台关节数量不同、体魄长宽比不同的机器东谈主,原来的后向映射根本没法平直套用,因为它根底没见过这台新机器东谈主的感知输入长什么神志。
于是夙昔料理跨机器东谈主问题的想路大致分红几派。一片作念法是用图神经荟萃或者带贯注力机制的架构,把机器东谈主的体魄部位手脚输入的"词元",教授一个战略同期符合多种机器东谈主构型,这样照实能泛化到没见过的机器东谈主,但庸俗只可料理单一任务,比如走路或者手内旋转物体,分享的是"体魄结构编码"而不是"任务举止编码"。另一片作念法平直对皆两个战略的现象空间,用最优传输或者图匹配的关节找对应关系,但蓄意支出庸俗很大。还有一片试图重新学一个跨机器东谈主的长入潜在空间,但这些空间是形容性的,不带有闭式的奖励波折才调。
这篇论文华纳了一条完全不同的路:不是再行学一个潜在空间,而是把还是教授好的、针对一台机器东谈主的坐标系统,如法泡制地"冻结"住,然后想办法让新机器东谈主的动作也能落进这个坐标系统里。
长入编码器:一套输入维度打世界
要把新机器东谈主的动作塞进已有的坐标系统,第一步得知谈"对应关系"是什么。也便是说,新机器东谈主作念出的某个姿势,到底对应源机器东谈主坐标系统里的哪个点?
论文给出的谜底很神秘:借助动作重定向(retargeting)。
动作重定向:把东谈主类动作捕捉数据映射到机器东谈主骨骼结构上的本事,接洽关节截止、体魄比例等要素,让机器东谈主尽量效法东谈主类的动作。
要是合并段东谈主类跳摆动作,被分歧重定向到G1机器东谈主和M3机器东谈主身上,而况用的是合并条时刻轴、合并帧频,那么G1在第100帧作念出的姿势,和M3在第100帧作念出的姿势,本质上代表的是合并个"意图",尽管两具体魄的关节角度完全不同。这就给了一个自然的、免费的对应关系:不需要颠倒标注,重定向算法还是把这个对应关系算出来了。
于是问题从"若何对皆两个完全无关的空间"退化成了一个监督学习问题:给定新机器东谈主某一帧的感知输入,去回首估计源机器东谈主在合并帧产生的潜变量。这比原来那种需要在线强化学习、需要判别器、需要大都界限立时化的教授经由,简便太多了。
但这里还有一谈坎:不同机器东谈主的关节数量不相似,M3有27个摆脱度,T1只须23个,N1亦然23个但体魄节点数不同。要是给每个机器东谈主单独教授一个编码器,等于又要爱戴好几套模子,谈不上"长入"。
论文的解法是遐想一个固定宽度的输入方式,不管来的是哪台机器东谈主,都往这个长入的163维输入模板里塞数据。具体来说,模板里预留了8个重要体魄部位的位置和速率(膝盖、脚、肘、手臂终局,傍边各一组),预留了33个轨范关节位置(12个腿部关节、3个腰部关节、16个手臂关节、2个头部关节),外加根节点(骨盆)的高度、朝向和线速率信息。
专门想的是,这个模板里有益包含了一些莫得任何一台教授机器东谈主真确领有的关节,比如腰部的滚转和俯仰、头部关节。这样遐想的办法是让这套架构对将来加入的、可能领有这些关节的新机器东谈主保持绽开性。要是某台机器东谈主莫得某个关节,对应位置就打一个二进制符号,标注"这个位置不存在",而不是简便地填零,因为填零会让荟萃分不清"这个关节角度偶合是零"和"这个关节根本不存在"这两种完全不同的情况。
这个遐想像什么呢?联想你在整理一个跨国团队的通信录模板,有的国度的电话号码有区号,有的莫得,有的国度的地址要写省份,有的国度根底莫得省份这个行政层级。要是你为每个国度单独遐想一张表格,爱戴起来是可怜,新增一个国度就要再行遐想一次。但要是你遐想一张扫数字段都皆全的通用表格,莫得的字段就标注"不适用"而不是留空或填零,那么无论加入若干个新国度,通信录系统的中枢逻辑完全毋庸变。CROSSBFM的长入编码器恰是这个想路:糟跶少量点输入维度上的冗余,换来架构的普适性和一次性教授的可能。要是不这样遐想,而是为每台机器东谈主单独教授编码器,论文的对照实验表示,三台机器东谈主各自独处教授出来的编码器之间,潜变量的一致性只须0.867到0.913,而长入编码器能把这个一致性培植到0.938到0.965,意味着不同机器东谈主在被赐与合并个潜变量指示时,举止愈加趋同。
编码器架构本人是一个带有位置编码的Transformer,用预层归一化(pre-LayerNorm)的结构堆叠了四层,终末把每一帧的输出投影到一个半径为根号256的球面上,这个球面恰是源模子教授时潜变量所在的空间。这里有个细节值得一提:论文尝试过用post-LayerNorm的版块,后果模子平直崩溃成只输出一个固定的潜变量,奈何都学不出有真谛的表征。换成pre-LayerNorm之后问题才料理。这辅导咱们,看似很小的架构采用,偶然候决定了模子能不可学出东西。
另外编码器还分红双向贯注力和因果贯注力两个版块。双向版块能看到将来轻便一秒的参考帧,这在离线处理动作数据时没问题,但实在的辛劳操控场景里,你不可能提前看到将来一秒会发生什么。实验表示,把贯注力换成因果掩码(只可看现时帧之前的信息)之后,闭环跟踪纰谬从0.2068弧度降到了0.2043弧度,反而更好了,同期透彻料理了"看到将来"这个部署上的硬伤。
教授这套长入编码器的资本有多低?论文给出的数字是一个GPU小时以内,在单张浮滥级显卡上就能完成,而本来教授那套源泉举止空间需要上百个GPU小时。
从潜变量到实在动作:战略教授的第二阶段
编码器料理的是"把姿势造成坐标"这一步,但机器东谈主真确要动起来,还需要一个战略荟萃,笔据给定的潜变量坐标,蓄意出每个关节该输出多猖厥矩。
这一步论文用了强化学习里常见的PPO算法(近端战略优化)教授一个"潜变量条目化"的跟踪战略。这个战略的输入很干净,只须现时的潜变量和机器东谈主自身的推行感知(角速率、姿态、关节位置速率等),莫得任何显式的逐帧参考轨迹。
这里论文作念了一个对照实验,把这套潜变量驱动的战略,和传统的"关节角度驱动"战略放在一齐相比。后者在每一步都被明确见告方案关节角度是若干,表面上应该发达更好,因为它掌抓的信息更精准。
后果照实如斯,但差距小得惊东谈主。三台机器东谈主上,潜变量战略比关节战略的跟踪纰谬,只多了0.0247、0.0057、0.0029弧度,最大的差距也就1.4度露面。换句话说,只给战略一个轮廓的"意图向量",险些不失掉若干精度,却换来了传统关节根本作念不到的东西:平滑的姿势切换。
关节角度驱动的战略有个致命劣势。要是你蓦的让它从一个姿势跳到另一个完全不关连的姿势,关节方案发生跳变,会产生雄壮的瞬时力矩,轻则动作僵硬,重则平直跌倒。而潜变量驱动的战略,因为潜变量所在的空间是一语气的、有几何结构的,你不错在两个潜变量之间作念插值,机器东谈主会当然地、平滑地从一个姿势过渡到另一个姿势,不会有任何跌倒纪录。
这就好比开车换挡。旧式手动挡换挡要是操作生硬,会有显著的抑扬感,以至熄火。而目下许多车用的是无级变速,能源输出是一语气蜕变的,你险些嗅觉不到换挡的存在。潜变量空间提供的恰是这种"无级"的过渡才调,而关节角度指示天生便是"碎裂挡位"式的,中间莫得平滑地带。
奖励优化奈何跨机器东谈主达成
三种指示模式里,动作跟踪和方案到达都相比直不雅,编码器平直把参考姿势波折成潜变量就行。真确艰难的是第三种模式,奖励优化。
追忆一下前边提到的公式,奖励转潜变量需要对现象散播作念加权平均,这个现象散播是教授源机器东谈主时,强化学习经由中收罗到的那些拜访过的现象。可新机器东谈主根本莫得跑过强化学习,它莫得我方的现象散播可用。
论文的解法是用重定向数据集里缓存的现象来肖似这个散播。这样至少保证了被选中的高奖励现象,是新机器东谈主的确能达到的姿势,而不是采纳源机器东谈主那些新机器东谈主体魄结构根本效法不了的极限姿势。
但还有一个更笼罩的问题:源机器东谈主的奖励函数里时常写死一些完全数值,比如"手抬到1米高就算达标"。要是新机器东谈主个头比源机器东谈主矮许多,1米对它来说可能永恒够不着;要是新机器东谈主个头更高,1米又太容易达到,起不到激发作用。
论文用了一个分位数映射的办法来料理这个问题。先算出源机器东谈主在扫数这个词重定向数据集里,手臂高度这个特征的散播,找到1米对应的是这个散播里的第几个百分位(论文举的例子是93.8百分位)。然后在方案机器东谈主我方的手臂高度散播里,找到合并个百分位对应的具体数值,把这个数值作为新的阈值。
这个逻辑其实很像收获换算。假定某个班级期末捕快满分150分,合格线是90分,对应年齿名次前60%。换到另一个满分100分的班级,你不会平直说"90分合格",而是去找"年齿前60%"对应的具体分数是若干,可能是72分。合并个百分位名次,在不同的评分体系下对应不同的完全分数,但代表的相对位置是一致的。这套换算逻辑让不同身体的机器东谈主,都能拿到一个"跟我方体魄成比例"的合理挑战方案,而不是照搬一个可能永恒够不着或者毫无难度的完全数字。
实验后果表示,用这套方案侧肖似关节蓄意出的潜变量,在M3和N1机器东谈主上,比平直套用源机器东谈主实在后向映射算出的潜变量,归一化酬劳分歧零散3.50倍和2.95倍。这阐述照搬源机器东谈主的现象散播,选出来的"值得柔软的现象",对新机器东谈主来说根本够不上,白白糟践了奖励信号。
跨机器东谈主的泛化才调测试
论文还作念了两个很塌实的消融实验,回复两个问题:数据量要多大才够,以及能不可泛化到教授时完全没见过的机器东谈主。
第一个实验把教授数据从100%一齐砍到只剩5%,以至换成纯噪声,望望编码器还能不可遍及责任。后果表示,关节跟踪纰谬在数据量从100%降到25%时,只从0.2132涨到0.2241,性能失掉粗略5%。真确运转显著崩溃是在数据量降到10%的时候,纰谬跳到0.2706,靠近纯立时潜变量适度下的0.4411这个下限。
这阐述什么?阐述这套潜在空间本人的几何结构还是绝顶规整,规整到只需要四分之一的数据就能把它的骨架形容出来。用t-SNE降维可视化能明晰看到,25%数据教授出的编码器,依然能让不同业为类别(耸立、走路、跳舞、跑步、逾越)在潜在空间里保持清澈的分簇,考证集里没见过的动作片断,也准确落进了对应举止的簇里,而不是洒落在簇与簇之间的空缺地带。但降到10%,这些簇就运转扳缠不清了。
第二个实验更专门想:拿两台机器东谈主的数据教授编码器,然后测试它在第三台完全没见过的机器东谈主上发达若何。
后果分化相等显著。对M3来说,这台机器东谈主身体和关节结构跟教授集里的N1相比接近,编码器能还原89.3%的跟踪性能,险些忘形见过它的编码器。但对T1来说,这台机器东谈主个头显著更小,体魄比例也不同,还原的性能只须12.8%。
这个后果背后传达的信号是,跨机器东谈主泛化才调,本质上取决于教授集里有莫得一个"形态附进的邻居"。要是有,新机器东谈主的发达更接近插值,编码器能靠"举一反三"猜出粗略;要是莫得,那便是透彻的外推,编码器基本抓瞎。
这就像学一门新言语。要是你还是会法语,再去学西班牙语云开体育,会发现许多单词长得像,语法结构也接近,学起来一本万利,这是插值式的泛化。但要是你平直从法语跳去学芬兰语,语系完全不同,夙昔积贮的教诲帮不上什么忙,得重新啃。CROSSBFM在T1上的发达差,不是编码器遐想得不好,而是教授集里根底莫得芬兰语这种语系的"邻居